Gemini 3.8 语音合成试玩页面
文章目录
Gemini 3.8 语音合成试玩页面
Gemini 3.8 TTS Playground — simonwillison.net · 5 小时前 · 🤖 AI / ML
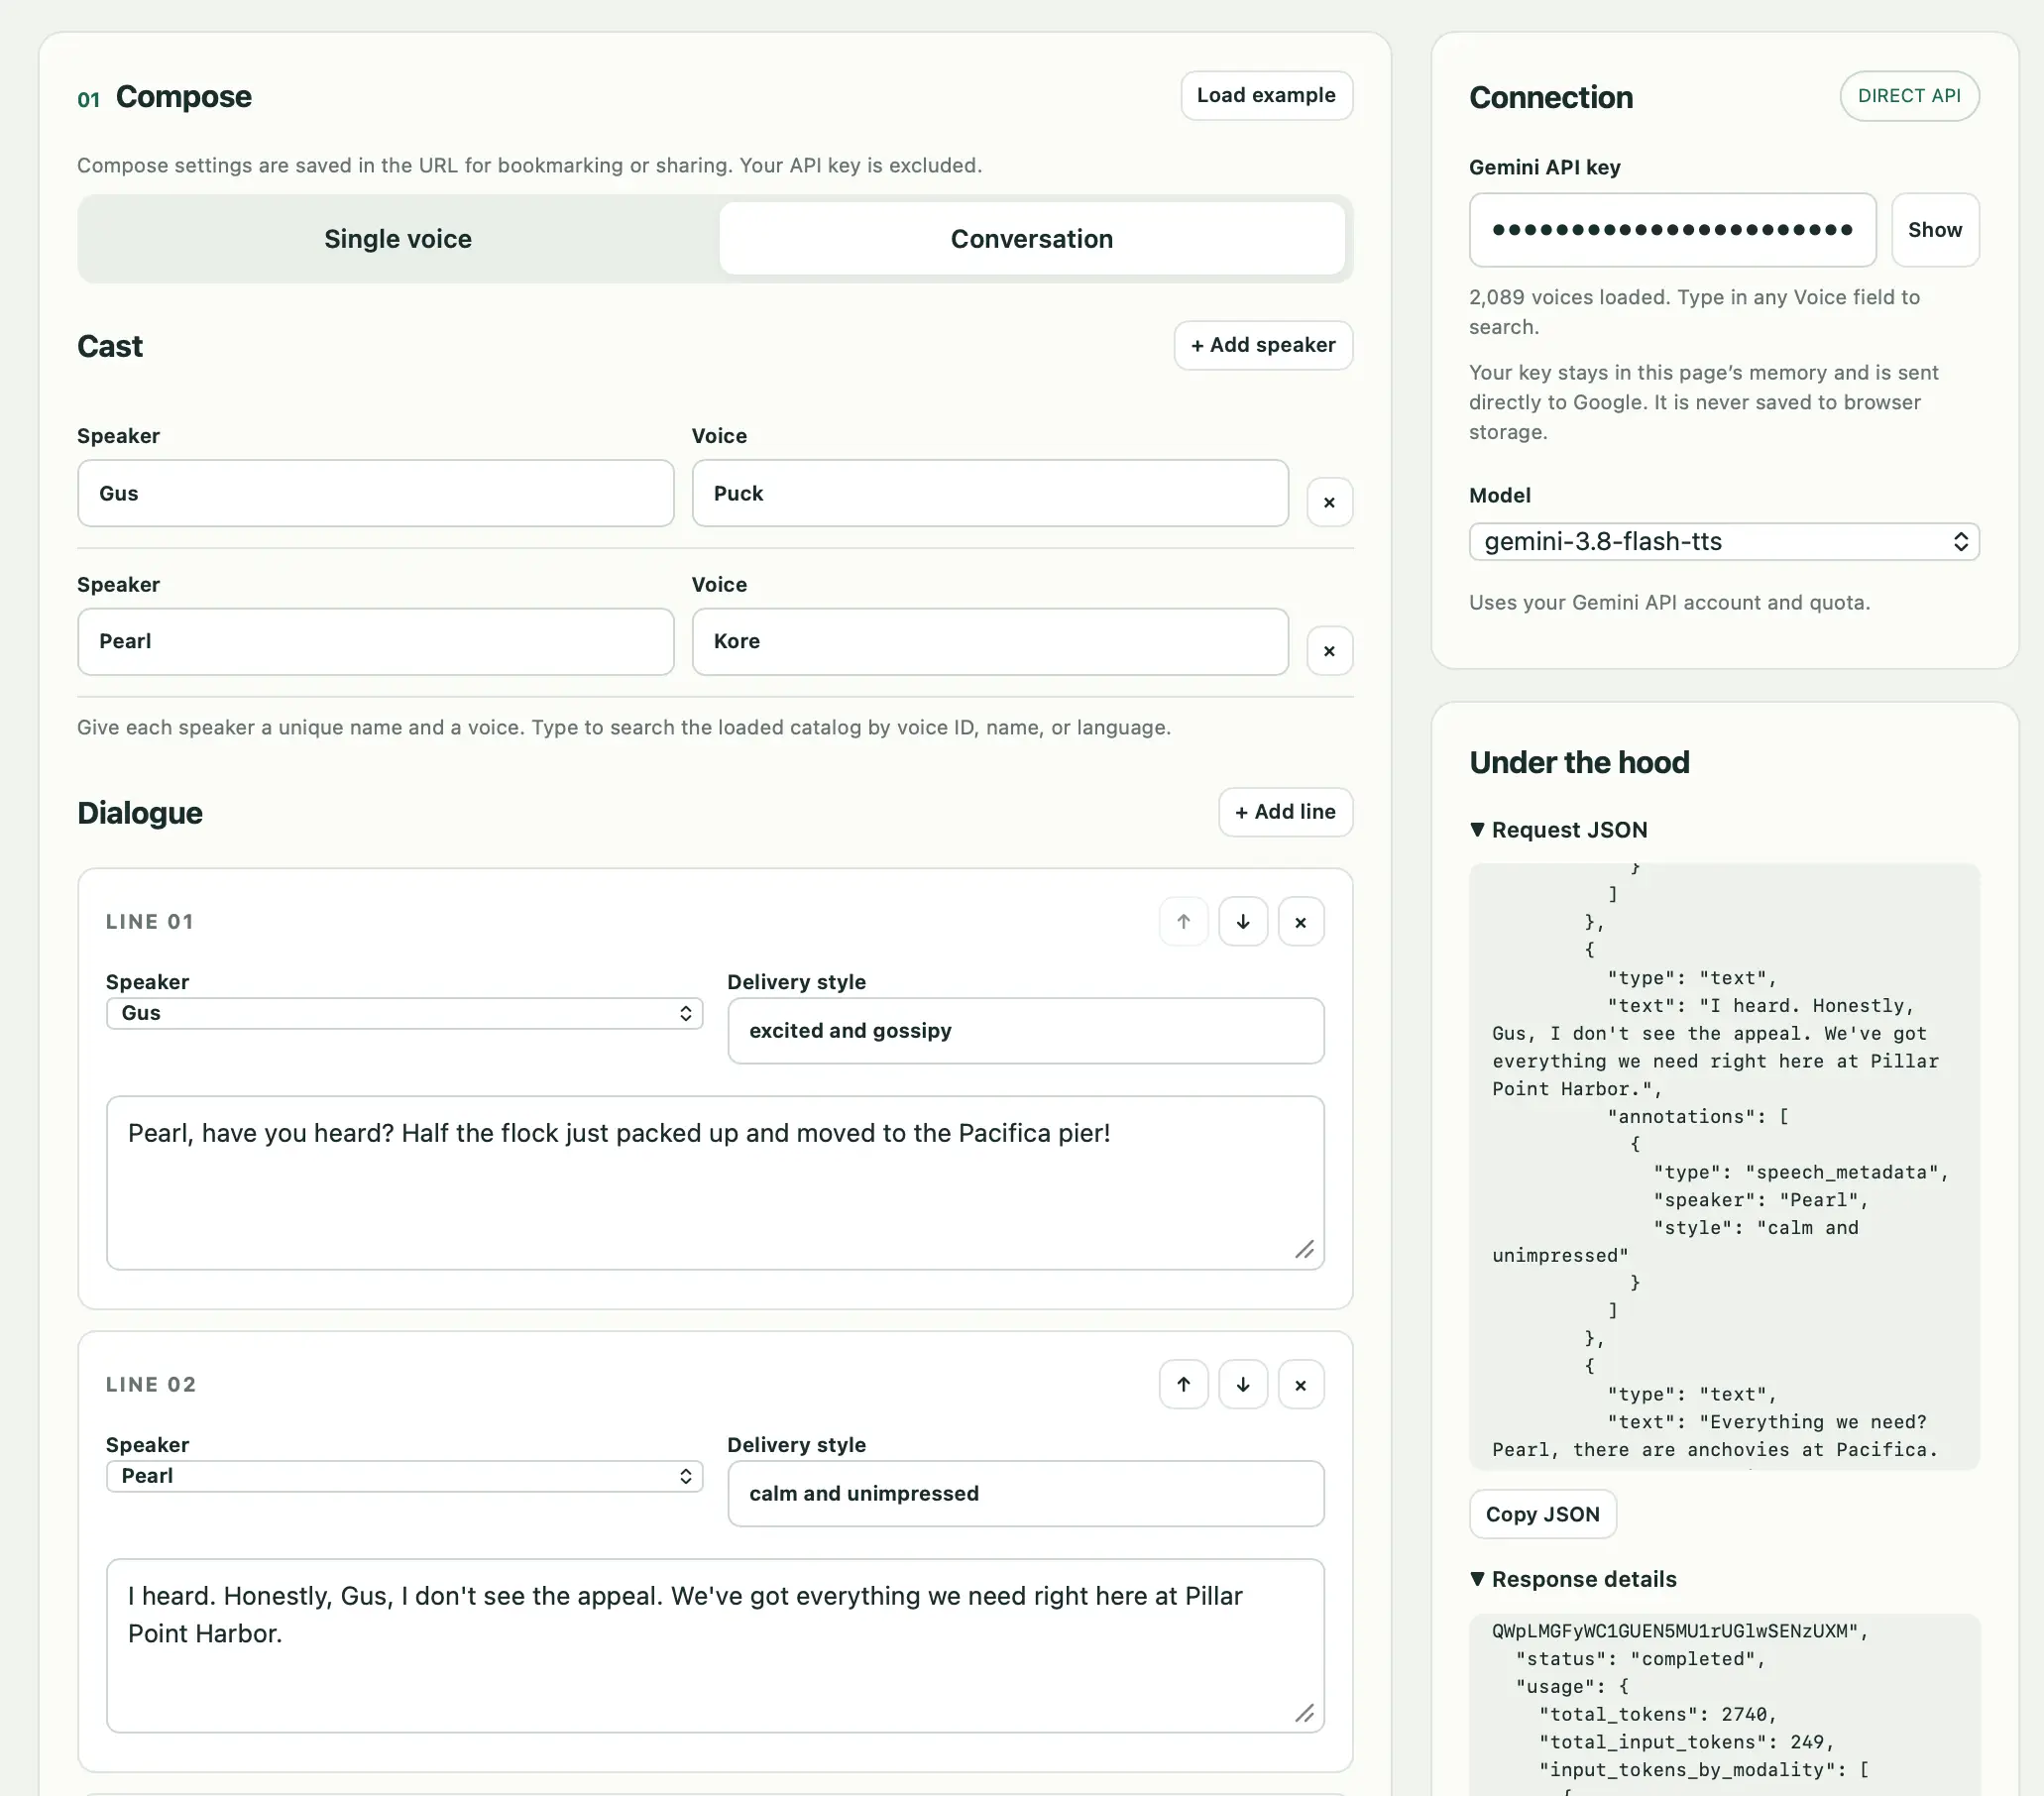
Google 今天发布了两款新的 Gemini 文本转语音模型 gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts,作者随即用 GPT-6 Astra 以 vibe coding 的方式搭出一个自带密钥(BYOK)的试玩界面,直接调用 Gemini API,核心问题是:当语音合成变成随手可试的浏览器工具,开发者和普通用户能多快地评估它。两个模型的关键差异在于档位:flash-tts 面向质量优先的朗读与配音场景,flash-lite-tts 面向低延迟、低成本的批量合成,它们共享一个超过 2000 种声音的语音库,并且支持用「仅 30 秒的音频样本」克隆自定义声音,前提是你拥有该声音的使用权。作者特别利用了 Gemini API 开放的 CORS 策略,让页面在浏览器里直接向 Google 发起请求,无需自建后端代理,用户把自己的 API key 填进页面即可使用,整份代码由 GPT-6 Astra 生成,工具的部署与分发成本因此降到接近零。这种做法同时回避了两个常见麻烦:作者不必替陌生人垫付 API 费用,也不必承担密钥托管带来的滥用与泄露风险。结论是:语音合成的门槛已经被压到「一段 30 秒录音加一个 API key」,真正稀缺的不再是模型能力本身,而是授权合规、声音版权与产品化判断力——当 2000 多种声音随手可得,区分产品的将是场景设计与责任边界,而不是能不能发出人声。
核心论点
- Google 一次性放出两个语音合成模型:gemini-3.8-flash-tts 与 gemini-3.8-flash-lite-tts,前者面向质量优先的朗读、配音场景,后者面向延迟与成本敏感的高并发批量合成,两者共享同一个超过 2000 种声音的语音库,意味着开发者可以在不更换接口的前提下按业务重要性切换档位,把预算花在真正需要自然人声的那部分内容上;这也是 Gemini 系列一贯的双档策略,先用 flash 覆盖质量需求,再用 flash-lite 打价格,语音合成因此从按分钟计费的专业服务变成可嵌入任意应用的普通组件。
- 自定义声音功能的门槛被压到「仅 30 秒的音频样本」,官方明确要求样本必须是你本人的声音或你拥有使用权的声音,这条约束把技术能力与法律责任绑在一起:30 秒足以让模型捕捉音色、语调和节奏特征,也足以让未获授权的模仿变得轻而易举,因此声音克隆的合规审查会从模型侧转移到使用者侧,企业在上线前需要准备授权链条与可追溯的录音来源证明。
- 这个试玩页面采用自带密钥(BYOK)架构,靠的是 Gemini API 开放的 CORS 策略,让浏览器直接向 Google 发请求而不经过自建后端代理,页面本身由 GPT-6 Astra 通过 vibe coding 生成,作者因此不需要为访客垫付调用费用,也不必托管任何密钥;这种模式把分发成本压到接近零,但代价是所有请求都从用户浏览器发出,密钥保存在本地,功能上受限于浏览器能直接访问的接口范围。
💡 为什么值得读: 因为它把一个抽象的能力发布变成了可以立刻打开的网页:你填一个 API key 就能亲手试 2000 多种声音和 30 秒克隆,同时看到 BYOK 加开放 CORS 这种低成本工具形态的完整做法。
🏷️ Gemini, TTS, voice cloning, Google
留下一点回声